
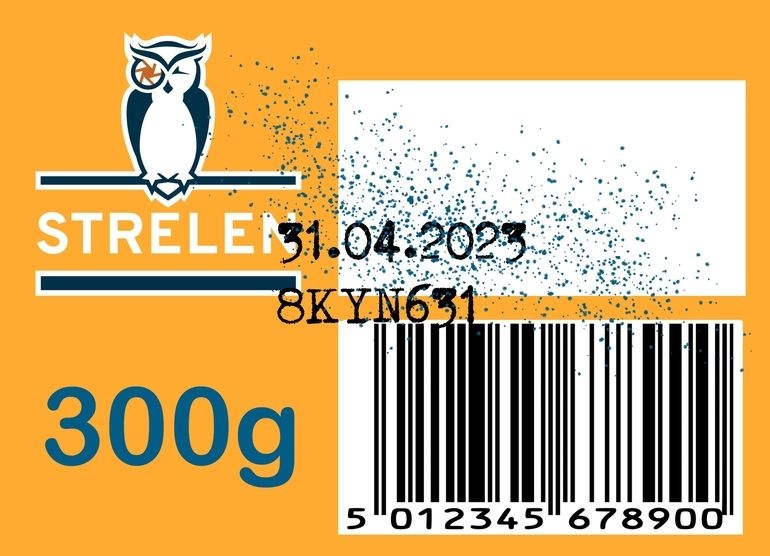
Verfahren, die auf Ähnlichkeitsanalysen beruhen und neuronale Netze zum Lernen nutzen, können auch zerstörte, verschmierte, qualitativ mangelhafte oder sonstige von der Norm abweichende Schrift auf Verpackungen zuverlässig lesen und prüfen. Dies vereinfacht die automatisierte Schrifterkennung in der Lebensmittelindustrie.
Auf verpackten Lebensmitteln finden sich in der Regel eine ganze Reihe aufgedruckter Daten. Diese können sich entweder direkt auf der Verpackung befinden oder mithilfe von Etiketten aufgebracht werden. Sie umfassen statische Daten wie Name und Adresse des Herstellers, die Produktbezeichnung oder die Inhaltsstoffe sowie variable Daten wie das Mindesthaltbarkeitsdatum (MHD), eine Lot-Nummer, eine Artikelnummer, eine Chargennummer und vieles mehr. Für den Verbraucher ist es unerlässlich, dass die vorhandenen Daten korrekt sind und er vertraut darauf, dass der Hersteller mit größtmöglicher Sorgfalt darauf achtet, seine Ware exakt zu etikettieren. Datenkontrolle hat daher eine hohe Priorität bei der Lebensmittelproduktion.
Automatisierte Schrifterkennung
Die Kontrolle von maschinenlesbarer Schrift unterliegt normalerweise automatisierten Prozessen, die industrielle Bildverarbeitung bietet hier mannigfaltige Lösungen. Soll jedoch Klarschrift gelesen werden, befinden sich die Drucke auf unruhigem Hintergrund oder sind möglicherweise teilweise zerstört oder qualitativ mangelhaft, kommen herkömmliche deterministische OCR-Algorithmen (Optical Character Recognition) rasch an ihre Grenzen. Nur optimal aufgebrachte Daten können zuverlässig gelesen werden. In anderen Fällen wird meist eine manuelle Stichprobenkontrolle durchgeführt, die fehleranfällig, teuer und zeitaufwendig ist.
Intelligentes OCR
Doch neue Entwicklungen in der künstlichen Intelligenz in Kombination mit OCR Verfahren bieten Lösungen. Neuronale Netze, ein Spezialgebiet der künstlichen Intelligenz, die mit Deep-Learning-Verfahren erzeugt werden, können lernen, Klarschrift auch unter schwierigen Bedingungen sicher zu erkennen: auf unruhigen Hintergründen, bei mangelnder Druckqualität oder ungewöhnlichen Schriftarten. Mithilfe einer großen Anzahl an Referenzbildern lernt das System, was die charakteristischen Aspekte jedes Buchstabens und jeder Zahl sind. Durch zahllose Feedbackloops, ob ein Buchstabe richtig erkannt wurde oder nicht, verfeinert das System seine Fähigkeit, Ähnlichkeiten zu erkennen und weiß so immer besser, worauf es achten muss, um einen Buchstaben oder eine Ziffer korrekt zu identifizieren. So kann es am Ende des Lernprozesses eine große Anzahl verschiedener Ausführungen eines Buchstaben lesen.



